
Viggle Research · 约 6 分钟阅读
每一刻,我们只能从一个视角看世界,但理解的远不止眼前可见的部分。移开视线,物体依然存在。我们可以想象绕到它们另一侧,也能预判它们如何运动、如何相互作用。
然而,许多世界模型仍在像素空间中学习,通过世界的外观间接学习其物理结构。
过去四年,我们一直在构建直接学习这种结构的模型架构。今天,我们推出 JST-2,我们的物理原生世界基础模型。它将场景、角色与动作带入一个可以进入和探索的共同三维世界,场景的生成与拓展只需数秒。
包含场景、角色与动作的世界
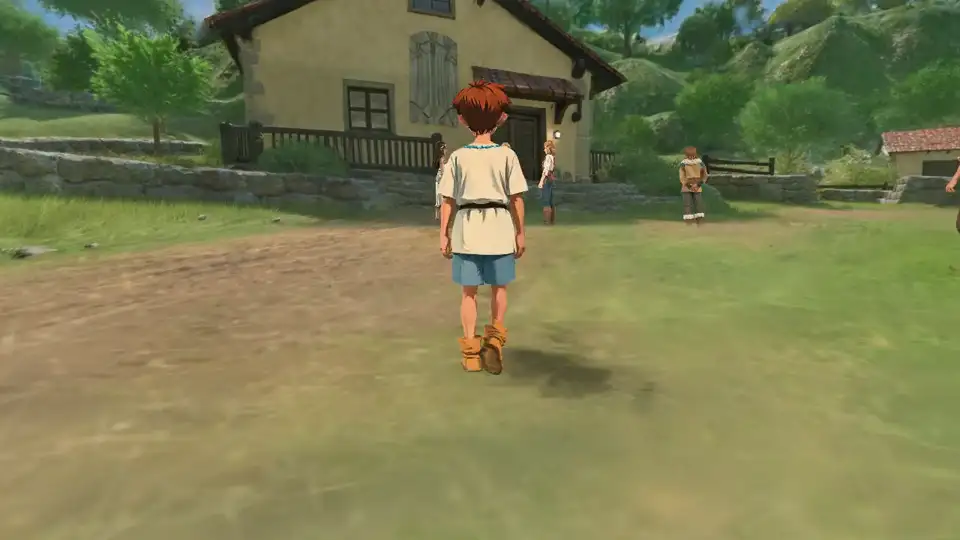
场景、角色与动作均由 JST-2 生成。
物理原生架构
JST 是 Joint Space-and-Time 的缩写,将世界表示为三维空间中持续存在的原子。每个原子代表一部分物质或一个物体部件,并在运动和形变中保持自身身份。其位置用显式 xyz 坐标表示,属性与动态则用可学习的向量表示。我们将这些原子编码为 Physics-Native Tokens。
围绕这一全新架构,我们从零构建了完整技术栈,包括编码器、生成器、解码器、物理原生数据合成引擎,以及预训练和后训练流程。同一种世界表示既可以从真实世界的观测中推断,也可以根据提示生成。
从场景的一张或多张输入图像开始。点按图像,探索编码器路径。
JST 编码器将图像映射为 Physics-Native Tokens,表示三维空间中的持久原子。
每个持久原子代表一部分物质或一个物体部件。其 Physics-Native Token 包含:
JST 生成器从多模态提示生成 Physics-Native Tokens。点按卡片,探索生成器路径。
绕着房间拖动相机。JST 解码器从这个视角生成解码后的场景图像。
解码器根据运动或力的输入,预测位置与属性的变化。拖动圆盘,探索这一输入。
JST 解码器将 token 解码为图像或三维高斯泼溅。点按任一输出,高亮显示其路径。
全部放在一起。拖动相机、推动圆盘、点按输入或输出。
我们于 2022 年创立 Viggle,并用最初两年研发 JST-1。JST-1 在角色生成与动画上验证了这套架构的可行性。它为 Viggle 的 meme 创作应用提供了模型能力,这款应用此后已触达全球超过五千万用户。
看到大家用它给彼此带来欢乐,我们一直很开心。感谢你们和我们一起创作,也感谢你们分享反馈,帮助我们持续改进模型。
在这些工作的基础上,我们于 2024 至 2026 年研发了 JST-2。它在场景、角色与动作生成上的能力,展示了 JST 架构的通用性。这种表示同时支持空间结构和随时间的变化。
以交互速度生成场景
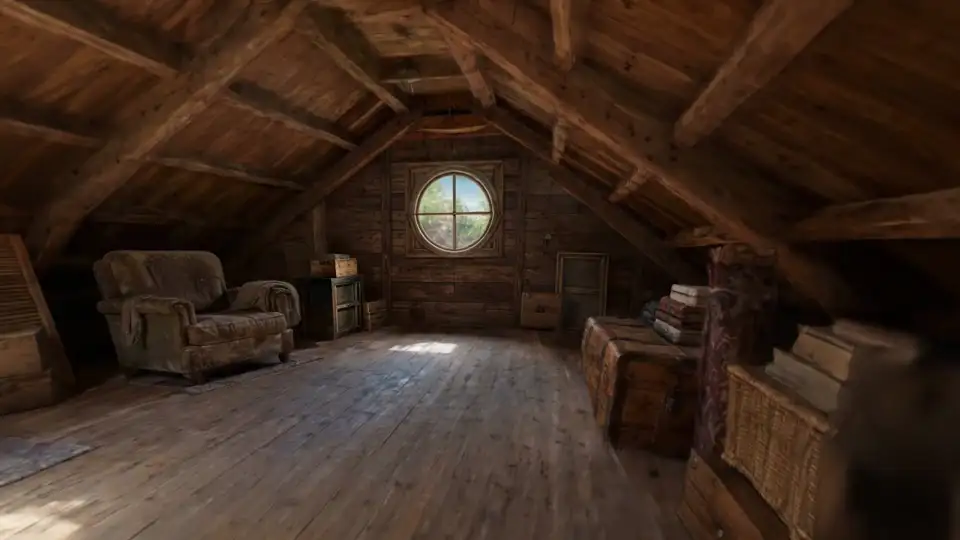
JST-2 生成一个 3D 场景约需一秒,推理成本低于 0.01 美元。其前馈架构直接生成三维表示,无需对每个场景单独优化。
探索与拓展
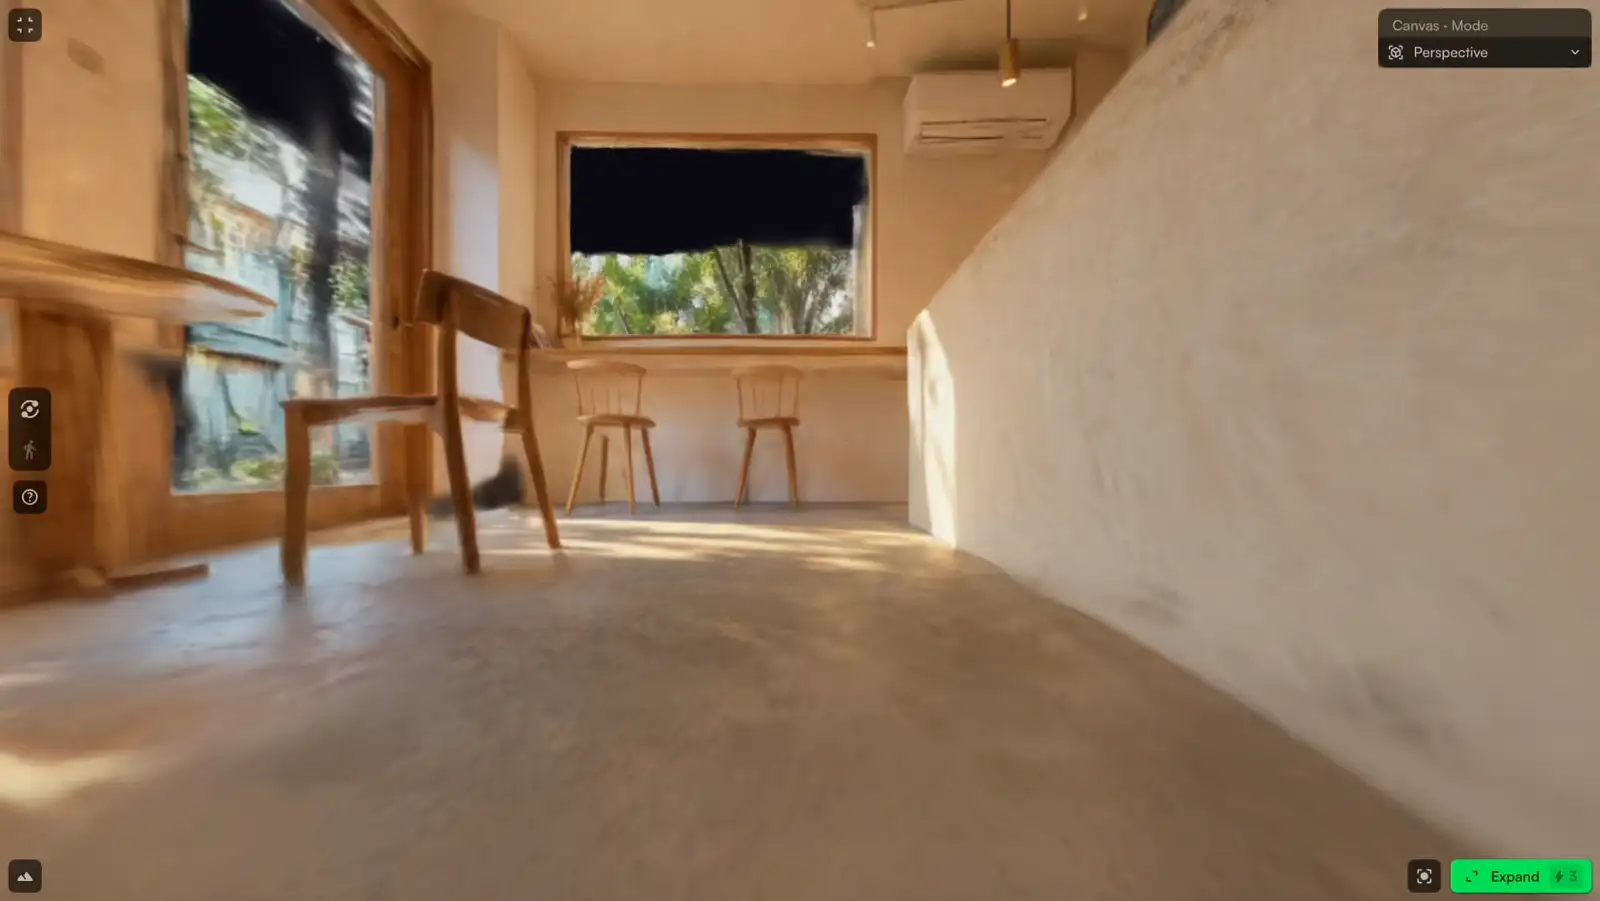
JST-2 支持最多 64 个输入视角,作为空间上下文窗口。当你一次一个视角地拓展世界时,每个新视角都会加入上下文,影响接下来生成的内容。
JST-2 将 Physics-Native Tokens 解码为 3D Gaussian splats,在浏览器中本地渲染。场景生成后,可以从不同视角反复探索,无需重新运行模型。只有生成新内容时才需要模型推理。
建模真实世界
JST-2 从稀疏的真实世界观测中重建完整的 3D 环境,同时保留其结构与外观。这提供了一种从真实地点构建和拓展机器人模拟环境的方式,也有望应用于自动驾驶、建图和建筑领域。
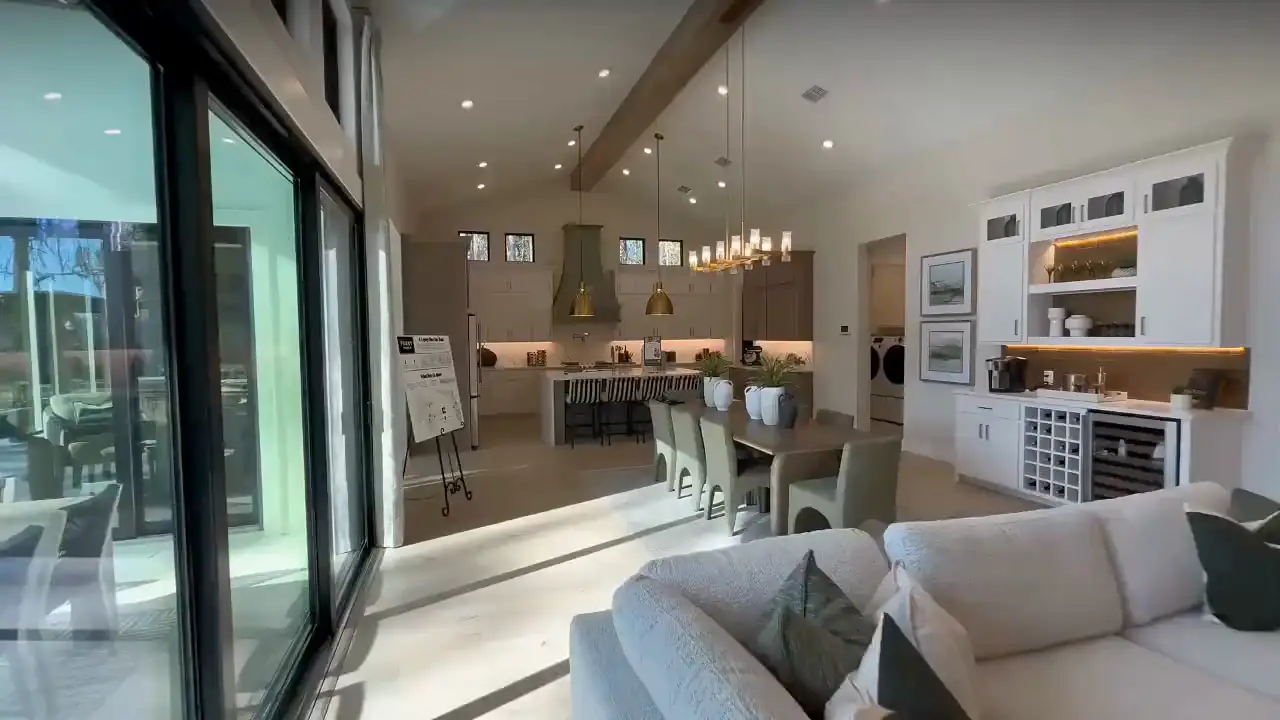
在接下来的版本中,你可以在拓展场景时,通过文本提示引导新空间中出现的内容。我们也在准备为每个场景生成更多 Gaussian splats 的版本,以呈现更精细的画面。
原生具备运动能力的角色
JST-2 从单张图片生成 3D 角色,无需单独绑定即可驱动。 试着创作你自己的
JST-2 根据文本或图片生成原生具备运动动态的 3D 角色。角色的 Physics-Native Tokens 中,动态向量编码了各部分在不同动作下如何形变。这些动态由模型从数据中学习,因此角色无需单独的绑定和蒙皮步骤即可驱动。
JST-2 也能从裁切或部分遮挡的图片中生成完整角色,覆盖广泛的视觉风格。
人工评审通过盲测,将 JST-2 与 Meshy 7.1、Tripo H3.1 进行对比。
JST-2 在角色生成上领先于两个对比模型,面部细节是表现最突出的评分项。这些细节有助于在 3D 中保留角色的身份辨识度。
Character generation | vs Meshy 7.1 | vs Tripo H3.1 |
|---|---|---|
| 平均分 | 58.4% | 73.2% |
| 服装质量 | 55.7% | 72.1% |
| 纹理质量 | 56.8% | 70.8% |
| 身体质量 | 56.8% | 74.2% |
| 面部质量 | 63.0% | 82.0% |
| Overall Preference | 59.9% | 66.9% |
为评估角色的可驱动性,我们对比了各模型生成角色的运动表现。JST-2 领先于两个对比模型,尤其体现在手部关节活动,以及身体和服装在运动中的形变。
动画可用性 | vs Meshy 7.1 | vs Tripo H3.1 |
|---|---|---|
| 平均分 | 73.8% | 88.9% |
| 关节对齐 | 65.6% | 85.9% |
| 骨架可用性 | 72.4% | 86.2% |
| 形变质量 | 77.6% | 93.2% |
| 手部绑定 | 82.8% | 89.3% |
| Overall Preference | 70.6% | 89.6% |
即将发布的版本将提升复杂服装在运动中的形变表现和毛发动态。
从文本或视频生成完整的 3D 全身动作
JST-2 根据文本或视频生成完整的 3D 全身动作。对于视频输入,模型重建可见的动作,并利用学习得到的动态推断不可见身体部位的运动。
JST-2 生成的动作可以直接应用于 JST-2 角色,无需单独的动作重定向步骤。它们也与标准 3D 角色骨骼原生兼容。这些角色和动作与生成的场景结合,构成了上文展示的完整世界。
人工评审通过盲测对比两项任务。所有动作均在同一个无贴图的 MetaHuman 骨架上播放,让对比聚焦动作本身,而非外观。
在文本生成动作任务中,JST-2 的各项评分均领先于两个对比模型。模型在手势和舞蹈上表现尤其突出,既遵循指令意图,也能生成自然、连贯的动作。
Text-to-motion | vs Cartwheel Swing | vs HY-Motion-1.0 |
|---|---|---|
| 平均分 | 74.8% | 80.0% |
| Prompt following | 65.8% | 76.5% |
| Motion quality | 79.8% | 80.2% |
| 足部接触 | 73.0% | 80.7% |
| Overall Preference | 80.7% | 82.8% |
JST-2 在视频生成动作任务中的总体表现领先于两个对比模型。重建的 3D 动作保留了原视频表演的节奏和速度变化,以及细微的手部与手指动作。
Video-to-motion | vs Cartwheel Comic 4 | vs DeepMotion Animate 3D |
|---|---|---|
| 平均分 | 58.1% | 89.1% |
| Motion accuracy | 56.7% | 90.9% |
| 复杂 / 快速 | 56.0% | 86.2% |
| 动作流畅度 | 57.1% | 82.8% |
| Hand tracking | 57.9% | 95.0% |
| Overall Preference | 62.5% | 90.6% |
即将发布的版本将从视频中重建人物在场景中的移动路径,同时还原其身体动作。我们也将提升动作准确度。
JST-3:走向 learned physics
在 JST-2 中,角色动作由学习得到的动态驱动。场景碰撞与物体交互仍依赖规则物理。我们正在研发 JST-3,用学习得到的动态取代这些规则,预测物体如何相互作用,以及这些交互如何改变世界。
我们的目标是为 physical AI 构建一个经验引擎,让 agent 通过在模拟世界中行动并观察后果来学习。